
표지가 붙은 동물이 다시 잡혔어요. 두 차례에 발견한 표지 수를 더해 적으면, 각 조사에서 몇 개였는지는 지워져요. 그 차이가 전체 동물 수의 추정에도 남을까요?
뉴질랜드 Department of Conservation의 자료는 재포획 분석에서 집단의 출입, 표지의 유지, 포획 기회 같은 가정을 확인하고 조사 회차 정보를 기록하도록 설명해요. 실제 양서류·파충류에서 포획 확률이 같다는 가정은 드물게 맞는다고도 경고해요. 여기서는 조사 방법을 권하는 대신, 그 가정들을 정확히 정한 자체 종이 모형을 사용해요.
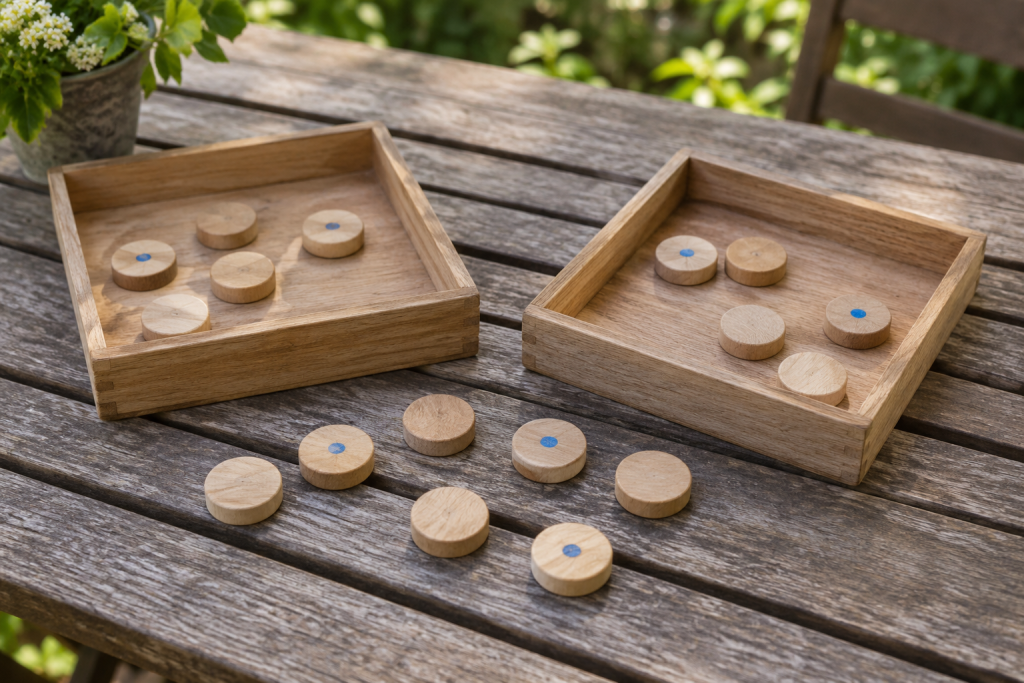
전체 개체 수 N 은 모르지만 3 개에는 표지가 붙어 있어요. 한 조사에서 서로 다른 3 개를 골라요. 모든 세 개짜리 부분집합의 확률이 같고, 조사 뒤에는 전부 돌려놓고 섞어요. 전체 집단과 표지 집합을 고정하면 두 조사는 독립이에요. 한 조사 안의 비복원 선택과, 두 조사 사이의 독립은 다른 조건이에요. 모형은 표지 없는 나무 조각과 표지 조각으로도 생각할 수 있어요.
첫째·둘째 조사에서 다시 나온 표지 수가 (0,2)였던 기록과 (1,1)이었던 기록을 비교해 봐요. 둘 다 합계는 2입니다. 하지만 두 기록의 확률을 가장 크게 하는 전체 수는 달라요. 첫 기록은 10 개에서 유일하게 최대이고, 둘째는 8 개와 9 개에서 동률이에요.
여기서 ‘가장 그럴듯한 수’는 뜻을 정해 쓴 말이에요. 후보 N 을 고정했을 때 현재 두 기록이 나올 확률 L(N)을 비교해요. L(N)은 N 자체의 확률이 아니에요. 사전분포를 넣은 사후확률도 아니며, 실제 동물 수를 알아냈다는 뜻도 아니에요.
왜 두 결과가 다를까요? 표지 a 개가 있는 전체 N 개에서 b 개를 골라 표지 k 개를 보는 경우의 수는 두 선택을 곱한 값이에요. 두 조사에서 표지 개수를 k₁,k₂라고 보존하면
제공 교재의 조합은 순서를 가리지 않는 선택을 세는 도구예요. 두 확률을 곱하는 단계에는 고정된 N 과 표지 집합 아래의 독립을 사용했어요. 조각의 표지 여부가 뽑힐 기회에 영향을 준다면 같은 계산을 자동으로 옮길 수 없어요.
각 열은 자기 기록 안에서 후보들을 비교한 값이에요. 서로 다른 기록 두 열의 확률 크기로 어느 조사가 더 정확한지는 판단하지 않아요.
| 후보 전체 수 N | 기록 (0,2)의 L(N) | 기록 (1,1)의 L(N) |
|---|---|---|
| 8 | 75/1568 | 225/784 |
| 9 | 5/98 | 225/784 |
| 10 | 49/960 | 441/1600 |
표의 세 후보만 확인해서 전체의 최대라고 선언할 수는 없어요. 더 작은 수와 더 큰 모든 정수도 검사해야 해요. 이 모형에서는 후보 수를 늘릴 때 기록 확률이 커지다가 작아지는 전환이 최대 한 번이에요. 그 일반 증명으로 표에 없는 후보까지 판단해요.
일반적인 표지 수 a, 조사 크기 b, 기록 k₁,k₂에서도 가능한 전체 수는
표지 없는 개체를 더 많이 요구하는 조사도 설명할 수 있어야 하기 때문이에요. 이 첫 후보보다 작은 수는 현재 기록 자체를 만들 수 없어요.
인접 비의 분자와 분모를 빼면 세제곱식 하나가 남아요. 두 기록이 모두 0 인 경우를 빼면, 그리고 두 조사 모두 가능한 최대 표지 수를 본 경우를 빼면, 그 식은 양의 구간에서 부호를 정확히 한 번 바꿔요. 그 전에는 다음 N 으로 옮길 때 기록 확률이 커지고, 뒤에는 작아져요. 전환점이 정수 사이면 최대도 하나이고, 정확히 정수에 놓이면 이웃한 두 후보가 동률이에요. 풀이에서는 모든 a,b,k₁,k₂에 대해 이 주장을 증명해요.
앞의 (0,2) 기록에서 9 개와 10 개의 차이는 작지만 정확해요. 확률의 비가 2401/2400 이어서 10 개가 조금 더 높아요. 그다음 후보로 가면 비가 4096/4235로 1 보다 작아져요. (1,1) 기록에서는 8 개에서 9 개로 갈 때 비가 정확히 1입니다. 표시를 반올림해서 우연히 같아 보인 동률이 아니에요.
표지가 두 조사에서 한 번도 나오지 않은 기록은 또 달라요. 이 모형에서는 어떤 유한한 전체 수보다 하나 더 큰 수가 그 기록을 더 높은 확률로 설명해요. 확률은 1에 다가가지만 유한한 최대 후보가 없어요. 계산기에 무한대라는 값을 넣는 것과 실제 집단이 무한이라는 결론은 구별해야 해요.
교사는 합계 2를 먼저 쓴 뒤 두 칸을 지운 학생에게 (0,2)와 (1,1)을 각각 다시 적어 보게 해요. 조사 크기와 표지 수까지 같아도, 각 회차의 분배가 사라지면 현재의 추정값 집합을 항상 되찾을 수는 없어요. 이 일반적인 정보 손실 교훈 자체가 새 발견은 아니에요. 질문의 중심은 이 명시된 모형에서 모든 후보와 동률·최대 부재를 빠짐없이 분류하는 데 있어요.
착안: Department of Conservation, Herpetofauna: population estimates (using capture-mark-recapture data), PDF 1–6 쪽. 집단과 표지에 필요한 가정, 회차 기록의 배경만 참고했어요. 두 독립 재포획의 수·자료 함수·전범위 분류·예시와 증명은 자체 교육용으로 작성했어요. 실제 동물 자료, 포획 절차, 사진·도판을 옮기지 않았어요.