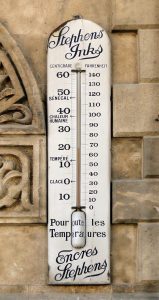
섭씨를 화씨로 바꾸니 구간이 넓어졌다, 더 확실해진 걸까요?
섭씨 독립25개 평균20·모표준편차5의95% 구간[18.04,21.96]을 Y=1.8X+32로 바꾸면[64.472,71.528]입니다. 숫자의 폭은 커져도 포함 사건은 정확히 같아 신뢰도는 그대로예요.
전체 글 / 카테고리
자료의 분모·집계범위·대표값·지수·표본과 추정·불확실성을 따져 결론의 의미를 읽는 글.
섭씨 독립25개 평균20·모표준편차5의95% 구간[18.04,21.96]을 Y=1.8X+32로 바꾸면[64.472,71.528]입니다. 숫자의 폭은 커져도 포함 사건은 정확히 같아 신뢰도는 그대로예요.
각각 같은 수의 자료가 들어 있는 두 구간을 보통 축과 로그 축으로 그려요. 막대 넓이가 개수를 나타내도록 높이를 정하고, 구간 폭과 밀도의 단위가 바뀔 때 숫자 높이를 바로 비교할 수 있는지 살펴봐요.
세 상자에서 하나를 뽑아 되넣고 다시 뽑는 종이 모형이에요. 각 장부의 추정값은 모든 추첨 결과를 평균 내면 실제 총무게와 같도록 정해요. 두 무게표에서 중복을 남긴 장부와 상자마다 한 행만 남긴 장부 중 어느 쪽이 덜…
두 보고만 있는 모형에서 실제 비율이 0인 경우를 계산해요. 음수나 1보다 크게 나온 추정 비율을 0~1로 제한하면 평균 제곱오차는 줄지만, 추정값의 평균은 실제 비율에서 벗어나요. 허용 범위에 맞추는 일과 평균을 맞추는 일을 구별해요.
부분별 증가율의 단순 평균과 전체 사용량의 증가율을 비교해요. 증가 전 기준량이 다른 경우에 필요한 가중치를 직접 계산해요.
가능한 값0,1,2만, 평균1·분산1/2이면 확률1/4,1/2,1/4로 정해져요. 가능한 값에3을 추가하면5/24,15/24,3/24,1/24도 같은 평균·분산이에요. 값의 목록이 필요한 조건이에요.
시계를 한 시간 뒤로 돌리는 전환을 포함한 가상의 기록이에요. 같은 날짜의 시각만 정렬하면 순서가 뒤집히는 이유와 두 기록 사이의 실제 30분을 계산해요.
A의 전후 점수는 5→9, B의 전 점수는 11·후는 빈칸, C의 전은 빈칸·후는 13입니다. 확인한 전 평균 8은 A,B, 후 평균 11은 A,C의 평균이에요. 그 차 3과 전후 모두 확인된 A의 향상 4는 다른 값이에요.
시작 번호만 고르면 출력이 정해지는 가상 프로그램을 봐요. 0과 1 여덟 자리의 가능성은 256개인데 시작값은 16개뿐이에요. 출력이 길어져도 가능한 결과의 개수는 자동으로 늘지 않는 이유를 세어요.
두 가상 식품을 10g 섞을 때 식품 무게와 단백질 무게의 비율을 구별해요. 두 성분의 기준비 중 작은 값인 지수 q를 가장 크게 하는 배합과, 총단백질량까지 반영한 보정량 J를 가장 크게 하는 배합을 비교해요.